在数据集成过程中,脏数据是不可避免的挑战。其中,重复数据、空值以及编码不一致是最为常见的三类问题。它们不仅影响数据质量,还可能导致分析结果偏差、业务流程中断。本文将系统探讨这三类脏数据的成因、检测方法及处理策略,帮助数据工程师和分析师有效应对。
1. 重复数据:识别与去重
1.1 重复数据的来源
重复数据通常由以下原因产生:
- 多个数据源合并时,同一实体在不同系统中重复记录;
- 数据采集过程中重复提交(如用户多次点击提交);
- ETL流程中多次加载同一批次数据。
1.2 检测方法
- 基于主键/唯一键:如果存在自然主键,可直接检测是否重复。
- 基于相似度:对于无主键的数据,可采用模糊匹配算法(如Levenshtein距离、Jaro-Winkler)识别近似重复。
- 基于聚合:统计各字段值的分布,若某组合频繁出现,则可能为重复。
1.3 处理策略
- 保留最新/最旧记录:根据时间戳或版本号保留一条,适用于时效性较强的数据。
- 合并记录:将重复记录的互补信息合并为一条完整记录,适用于信息分散的情况。
- 删除所有重复:若无法判断哪条更准确,且重复对分析无益,则直接删除。
- 预防措施:在数据入口增加唯一性约束,使用ETL工具的去重组件(如Informatica中的Sorter+Aggregator)。
2. 空值:缺失数据的处理
2.1 空值的来源
- 数据采集时未填写必填项;
- 数据传输中丢失;
- 不同数据源合并时字段不对齐。
2.2 影响
空值会导致计算错误、模型训练失败、报表空白等问题。
2.3 处理策略
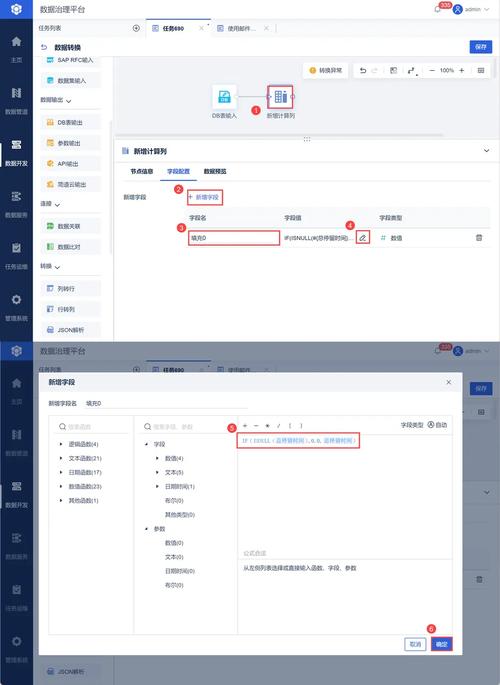
- 删除:若空值比例较低(如<5%),可删除包含空值的记录。
- 填充:
- 固定值填充:如“Unknown”,适用于分类字段;
- 统计值填充:均值、中位数、众数,适用于数值型字段;
- 插值填充:基于时间序列进行线性插值或滑动平均;
- 模型预测填充:使用回归、KNN等算法预测缺失值。
- 标记法:将空值单独作为一类,保留缺失信息。
- 预防措施:在数据录入时进行非空校验,设计阶段考虑字段可为空的业务逻辑。
3. 编码不一致:统一字符集与格式
3.1 编码不一致的表现
- 字符集混乱:如UTF-8与GBK混用导致乱码;
- 日期格式不统一:如“2023-01-01”与“01/01/2023”;
- 单位不一致:如“1kg”与“1000g”;
- 大小写与空白问题:如“Beijing”与“beijing ”。
3.2 检测方法
- 使用编码检测工具(如chardet)识别字符集;
- 定义格式规则,通过正则表达式验证字段格式;
- 统计字段值分布,发现异常编码。
3.3 处理策略
- 字符集统一:将数据统一转换为UTF-8编码,使用iconv或Python的encode/decode。
- 格式标准化:
- 日期时间:统一为ISO 8601格式(YYYY-MM-DD HH:MM:SS);
- 数值:统一单位和小数位数;
- 文本:去除首尾空格,统一大小写(如全小写)。
- 映射转换:建立编码映射表,将不同来源的编码转换为一致值。
- 预防措施:在数据集成规范中明确字符集与格式要求,使用数据质量工具(如Apache Griffin)进行监控。
4. 数据集成中的综合处理流程
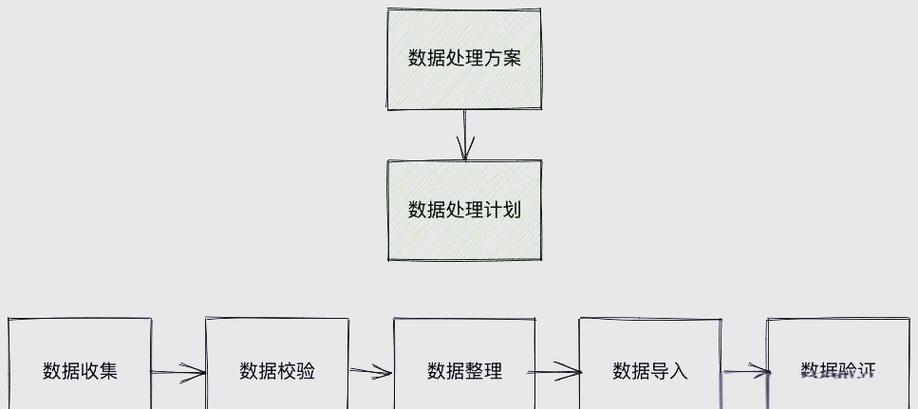
实际项目中,脏数据处理应集成到ETL流程中,建议如下步骤:
- 数据剖析:使用工具(如Pandas Profiling)了解数据质量概况;
- 定义规则:明确重复、空值、编码的检测与处理规则;
- 转换清洗:编写脚本或使用ETL工具执行清洗;
- 验证与监控:清洗后抽样检查,并持续监控数据质量指标。
5. 工具与最佳实践
- 开源工具:OpenRefine(交互式清洗)、Pandas(Python库)、Kettle(ETL工具);
- 商业工具:Informatica Data Quality、IBM InfoSphere QualityStage、Talend;
- 最佳实践:
- 建立数据质量度量体系(如完整性、唯一性、一致性);
- 在数据源头避免脏数据产生;
- 文档化清洗规则,保证可重复性。
6.
重复、空值和编码不一是数据集成中的三大脏数据问题,处理它们需要结合业务需求选择合适策略。通过技术手段、流程规范和工具支持,可以有效提升数据质量,为后续分析应用奠定可靠基础。数据清洗不是一次性的任务,而应作为持续的数据治理活动。